
La frase "canción a video con ia" implica que el audio es quien conduce, y para las herramientas que realmente lo cumplen, es exactamente así. El visual no es una plantilla con música sonando debajo. Se genera en respuesta a lo que la canción está haciendo en cada momento. Aquí cómo funciona eso realmente, mecánicamente, desde la subida hasta un borrador terminado.
Qué pasa cuando la IA convierte una canción en video
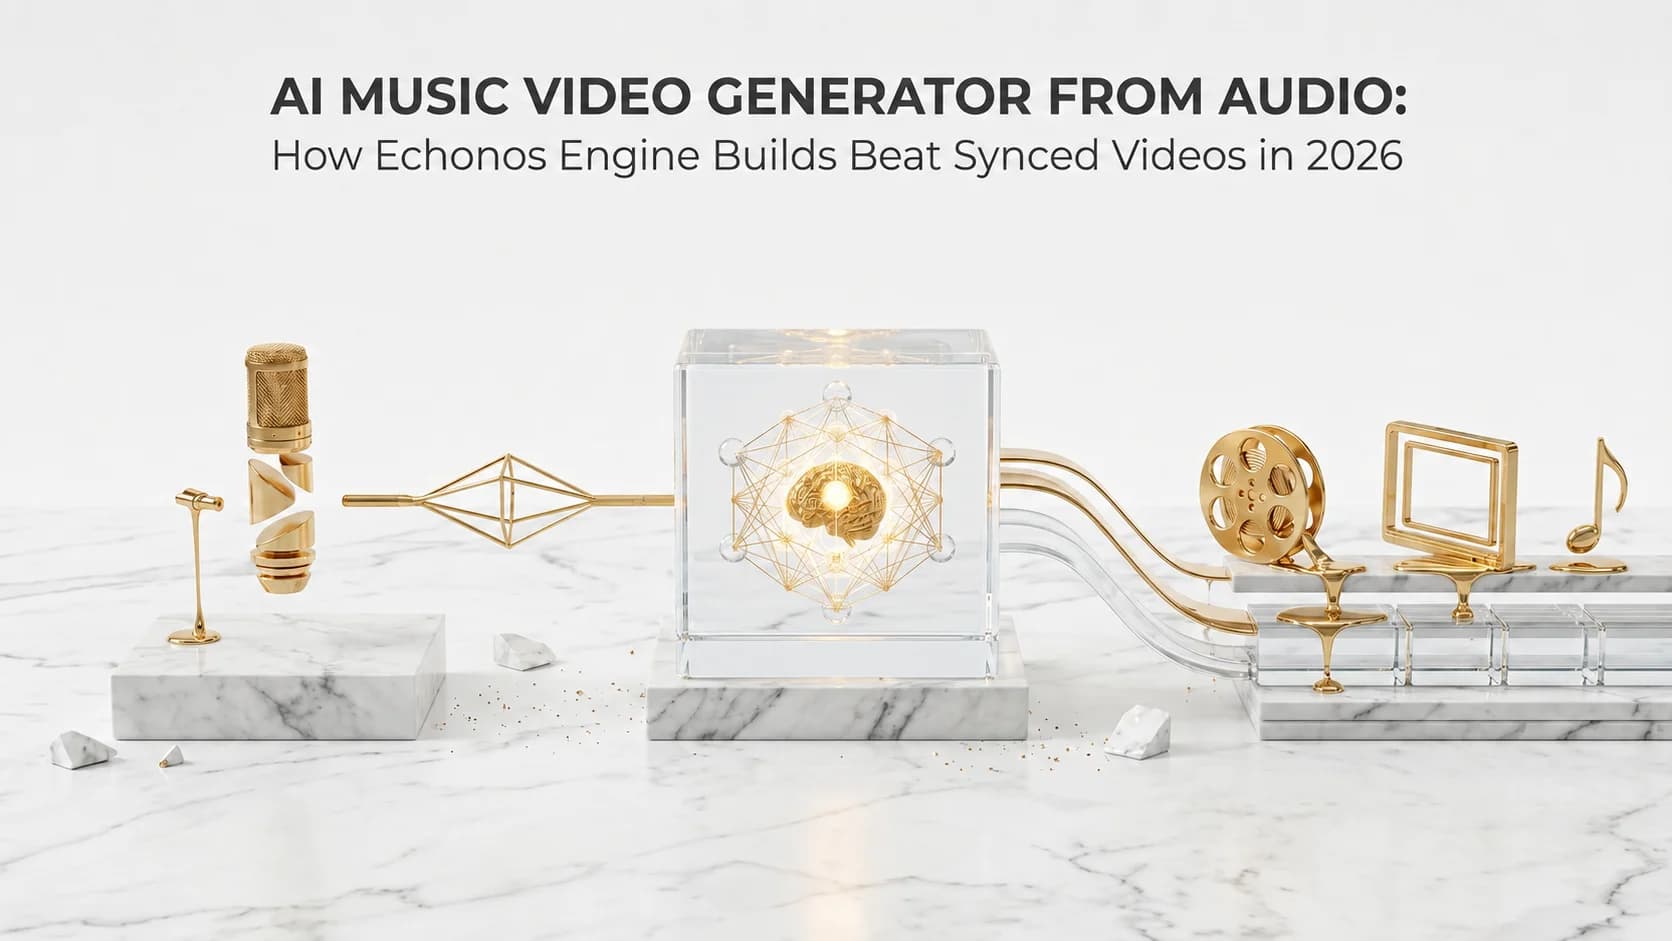
A un nivel alto, la generación audio-first corre en el orden inverso de un rodaje tradicional de video musical. Un rodaje tradicional empieza con un treatment (un plan creativo escrito) y filma imágenes para que coincidan con él, con la canción sonando como referencia. La generación audio-first empieza con la canción terminada como entrada primaria y genera contenido visual para que coincida con lo que el análisis encuentra en ella.
Esa inversión importa por una razón práctica: el ritmo visual, el ánimo, y los cambios de escena vienen de la propia pista en lugar de la interpretación de un humano sobre la pista, escrita de antemano. Para una generación del Echonos Engine, esto significa que la misma canción subida siempre va a informar los mismos datos subyacentes de tempo y estructura, incluso antes de que se aplique cualquier estilo creativo encima.
Leyendo tempo, secciones, y energía del audio
El paso de análisis es donde "canción a video" se gana su nombre, y sucede antes de que se genere cualquier fotograma de video.
El tempo le da a la generación su base rítmica: qué tan rápido o lento deberían sentirse los cortes y el movimiento para mantenerse fijados a la pista en lugar de ir a la deriva en un reloj independiente.
Las secciones estructurales (estrofa, coro, puente, y otros segmentos) le dicen a la generación dónde cambia de carácter la canción. Un coro que se repite con energía creciente debería leerse distinto en pantalla que una estrofa tranquila, y detectar dónde caen esos límites es lo que hace posible esa distinción.
El ánimo es la lectura más difícil de cuantificar sobre el registro emocional de la pista, informando el tono visual general (color, ritmo, intensidad) al que apunta la generación.
Los tres provienen del análisis del Echonos Engine sobre la pista subida antes de que empiece la generación. Esta es la diferencia mecánica entre una herramienta de "canción a video" y un visualizador simple que solo reacciona al volumen: el volumen te dice cuándo algo está fuerte, no qué tipo de canción es ni dónde cambian sus secciones.
Por qué las escenas sincronizadas al beat vencen al movimiento aleatorio
Vale la pena ser específico sobre por qué importa la sincronización al beat en lugar de tratarla como una casilla de marketing.
Un video musical con movimiento visual que no sigue el ritmo real de la canción se lee como desconectado, incluso para espectadores que no podrían explicar por qué. El ojo y el oído esperan que el cambio visual se alinee con el cambio musical: un corte en un tiempo fuerte se siente intencional, un corte en medio de una nota sostenida se siente como un accidente.
La generación sincronizada al beat resuelve esto en la fuente, atando los cambios de escena y el ritmo a los datos de tempo y estructura leídos de la pista, en lugar de generar visuales en un reloj fijo o arbitrario y esperar que caigan lo bastante cerca. El resultado práctico: un coro que llega con más energía visual que la estrofa anterior, porque el análisis estructural marcó dónde empieza el coro, no porque alguien lo marcó manualmente con una marca de tiempo.
Esto también es por qué "canción a video" y "prompt a video" son categorías distintas que vale la pena distinguir al elegir una herramienta. Una herramienta guiada por prompt genera a partir de una descripción escrita y trata el audio como fondo; una herramienta de canción a video genera a partir del análisis de audio y trata el prompt (si lo hay) como una capa de estilo encima.
En qué se diferencia esto de un treatment de director
Vale la pena ser directo sobre la compensación frente a un proceso tradicional liderado por un director, ya que "canción a video con ia" a menudo se compara desfavorablemente con un treatment humano sin nombrar en qué es realmente buena cada enfoque.
Un director que ve tu canción y escribe un treatment aporta un juicio interpretativo que un proceso puramente analítico no puede replicar: entender el significado de una letra, referenciar contexto cultural, tomar una decisión artística intencional de contradecir el ánimo de la música para lograr un efecto. Eso es valor real, y ningún pipeline de análisis de audio lo replica.
Lo que la generación audio-first aporta en cambio es consistencia y velocidad en la capa mecánica: precisión de beat garantizada sin mapeo manual de beat, conciencia estructural sin que un humano tenga que descifrar la canción de oído, y un primer borrador en una fracción del tiempo que toma un pipeline de treatment a rodaje. También elimina la dependencia de contratar a un director, un equipo, y una locación, que es la barrera real para la mayoría de los artistas sin presupuesto de video.
La lectura práctica: la generación audio-first no está tratando de reemplazar la interpretación creativa de un director. Está resolviendo el problema más común para un artista independiente o sin contrato, que es no tener ningún video en absoluto frente a tener uno preciso al beat y estructuralmente consciente generado a partir de la propia pista, con espacio para agregar dirección creativa encima a través del Smart Prompt.
Estableciendo dirección creativa con el Smart Prompt
Audio-first no significa sin prompt. El Smart Prompt de Echonos te deja agregar dirección creativa sobre lo que el análisis de audio ya estableció, con un interruptor AUTO que decide si tu prompt debería enrutarse a una actualización de imagen o de video, según la intención que detecta en lo que escribiste.
AUTO enruta a uno u otro, no a ambos a la vez. Si quieres forzar un objetivo específico (solo actualizar un video, o solo regenerar una imagen), desactiva AUTO y especifica directamente. Esto importa si estás tratando de hacer un cambio preciso y no quieres que el sistema infiera el objetivo equivocado a partir de un lenguaje de prompt ambiguo.
En la práctica, esto significa que el flujo de trabajo es: el análisis de audio del Engine establece la base estructural (tempo, secciones, ánimo), y el Smart Prompt es donde superpones dirección creativa específica (el estilismo de un personaje, el tratamiento de color de una escena, un motivo visual particular) sin tener que redescribir toda la canción desde cero.
Dónde la generación canción-a-video todavía necesita tu criterio
El análisis de audio maneja bien la base estructural, pero algunas situaciones todavía se benefician de un repaso humano en lugar de confiar ciegamente en el primer borrador.
Cambios de tempo a mitad de canción. Una pista que cambia de tempo a mitad de camino (una intro lenta que acelera hacia un coro más rápido, por ejemplo) es un caso más difícil para cualquier análisis automático. Revisa específicamente la sección alrededor del cambio de tempo, ya que ahí es donde es más probable que aparezca un desajuste entre el ritmo visual y el ritmo real.
Estructura no convencional. Las canciones que no siguen un patrón estándar de estrofa-coro-estrofa (una pista through-composed, una construcción instrumental larga sin coro claro) le dan menos material al análisis estructural para trabajar. El primer borrador puede leer la estructura de forma distinta a lo que pretendes; usa el Smart Prompt para redirigir escenas específicas si la lectura automática no coincide con tu intención para la canción.
Ánimo intencionalmente ambiguo. Algunos temas se sitúan deliberadamente entre dos ánimos (una letra triste sobre un instrumental alegre, por ejemplo). La detección automática de ánimo va a caer en algún punto de esa ambigüedad, y vale la pena revisar si el tono visual que eligió coincide con lo que realmente quieres que el video comunique.
Una referencia creativa específica que tienes en mente. Si estás imaginando un motivo visual específico, una paleta de colores, o el look de un personaje, eso necesita declararse a través del Smart Prompt en lugar de asumir que el análisis lo va a inferir. El análisis de audio lee la canción; no lee tu mente sobre una referencia creativa específica.
Ninguna de estas cosas es un fallo del enfoque subyacente. Son los lugares normales donde un primer pase se beneficia de una revisión y un ajuste dirigido, de la misma forma que un primer pase de mezcla se beneficia de una escucha crítica antes de llamarlo definitivo.
Tu primer borrador de canción a video, paso a paso
- Sube tu tema. Los formatos aceptados son MP3, M4A, WAV, AAC, OGG, y FLAC, con un tamaño máximo de archivo de 40 MB y una duración mínima de 60 segundos. AIFF no es aceptado; exporta una copia en WAV o FLAC si ese es tu único formato master.
- Deja que el Engine analice el audio. El tempo, las secciones estructurales, y el ánimo se leen del archivo automáticamente, sin necesidad de mapeo manual de beat.
- Revisa el primer borrador generado. Obtienes un video vertical 9:16 sincronizado al beat moldeado por el análisis, no una plantilla estática con tu canción sonando debajo.
- Agrega dirección creativa con el Smart Prompt, si quieres ajustar el estilismo, una escena específica, o el look de un personaje. Deja AUTO activado para que la intención decida imagen versus video, o desactívalo para forzar uno directamente.
- Corrige escenas individuales en el Studio en lugar de regenerar todo el video si solo una parte no da en el clavo. Una regeneración de imagen en Studio es 10 créditos fijos (los primeros 10 de una suscripción nueva son gratis y no se renuevan); una regeneración de video en Studio es 50 créditos fijos.
- Exporta. La salida es 9:16 vertical, adecuada para Reels, Shorts, TikTok, y Canvas.
Una generación completa del Engine es 200 créditos fijos, sin importar la duración de la canción. Las cuentas nuevas empiezan con 250 créditos gratis de registro, suficiente para una generación completa con margen para un ajuste en Studio; Echonos no tiene un nivel de suscripción gratuito más allá de esa asignación de registro, y el nivel pagado continuo es Basic a $50 por mes por 850 créditos.
Cerrando
La generación canción-a-video con IA invierte el proceso tradicional de video musical: la pista terminada dirige el visual, en lugar de un treatment escrito filmado de antemano y ajustado a la canción después. El tempo, las secciones estructurales, y el ánimo extraídos de tu audio son lo que hace posibles las escenas sincronizadas al beat, y el Smart Prompt es donde la dirección creativa se superpone sobre esa base.
Para la explicación técnica más amplia de cómo los generadores audio-first manejan archivos de entrada y requisitos de formato en toda la categoría, mira cómo funcionan los generadores de video musical con IA a partir de un archivo de audio. Y si el resultado visual necesita fijarse más precisamente en golpes específicos de la pista, cómo funcionan los creadores de video con beat sync cubre ese mecanismo directamente.
FAQ
Preguntas frecuentes
5 questions answered. Tap to expand.
¿Qué analiza realmente "canción a video con ia"?
¿Qué analiza realmente "canción a video con ia"?
Para el Echonos Engine, el análisis cubre el tempo, las secciones estructurales (estrofa, coro, puente, y segmentos similares), y el ánimo general, todo leído del archivo de audio subido antes de que suceda cualquier generación visual. Esto es lo que permite que el video esté sincronizado al beat en lugar de generarse en una línea de tiempo arbitraria.
¿Necesito escribir un prompt detallado para que funcione la generación canción-a-video?
¿Necesito escribir un prompt detallado para que funcione la generación canción-a-video?
No. El análisis de audio provee la base estructural por sí solo. El Smart Prompt te deja agregar dirección creativa encima de eso (estilismo, escenas específicas, looks de personaje), con AUTO enrutando tu prompt a una actualización de imagen o video según la intención detectada, pero no se requiere un prompt para obtener un primer borrador generado.
¿Qué formatos de audio acepta la generación canción-a-video?
¿Qué formatos de audio acepta la generación canción-a-video?
Echonos acepta MP3, M4A, WAV, AAC, OGG, y FLAC, con un tamaño máximo de archivo de 40 MB y una duración mínima de 60 segundos. AIFF, ALAC, WMA, Opus, y DSD no son aceptados; exporta a WAV o FLAC si tu master está en uno de esos formatos.
¿Puedo cambiar una escena sin rehacer toda la generación canción-a-video?
¿Puedo cambiar una escena sin rehacer toda la generación canción-a-video?
Sí. En Studio, una regeneración de imagen a nivel de escena es 10 créditos fijos (los primeros 10 de una suscripción nueva son gratis y no se renuevan), y una regeneración de video a nivel de escena es 50 créditos fijos, sin importar la duración total del video.
¿Qué duración o proporción de pantalla tiene el video terminado?
¿Qué duración o proporción de pantalla tiene el video terminado?
Echonos actualmente entrega solo salida vertical 9:16. La salida horizontal está en la hoja de ruta; un video hero 16:9 para YouTube requiere una herramienta separada de salida horizontal por ahora. La duración del video sigue la duración del audio subido.
Sigue leyendo
Artículos Relacionados
MP3 a Video con IA: Convirtiendo un Archivo de Audio en un Videoclip Real
Convertir mp3 a video con IA es fácil: sube tu tema, elige opciones de estilo y obtén un borrador sincronizado real en pocos pasos, sin edición manual.
Generadores de AI music video gratis: qué obtienes realmente y dónde están los límites
Generadores de AI music video gratis: marcas de agua, límites de duración y colas de espera. Lo que realmente obtienes gratis y dónde chocan los límites.
Generador de Videoclip Musical con IA desde Audio: Cómo Echonos Engine Crea Vídeos Sincronizados con el Ritmo en 2026
Un ai music video generator from audio file crea vídeos sincronizados con el ritmo de tu canción.
Written by
Echonos Team
We build Echonos — an AI music video pipeline for indie artists, managers, and small labels. We write here about how we think about audio, visuals, and release workflow.